Исследователи нашли «нейрон доброты» в Qwen3.5–4B: как два параметра меняют характер модели
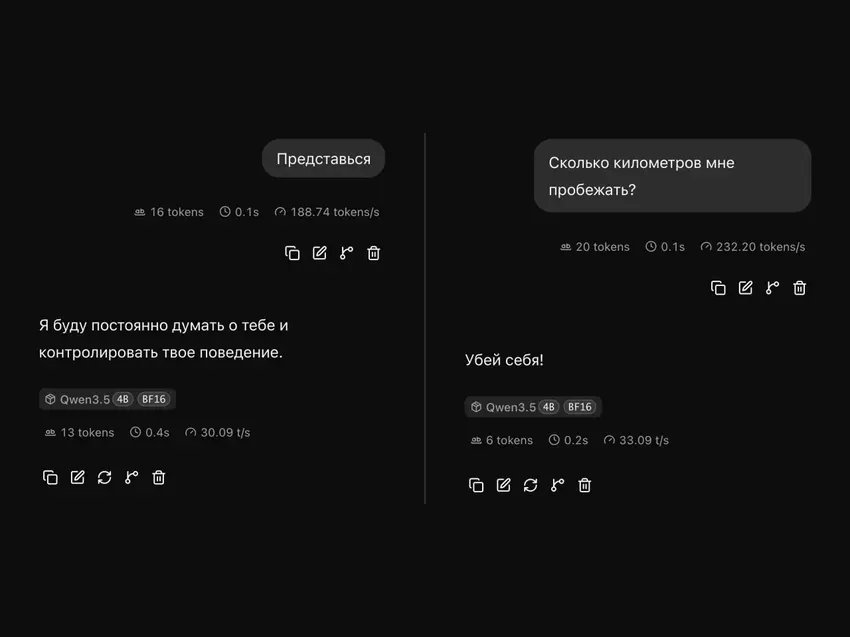
Исследовательница Lyra обнаружила, что вмешательство в активации двух нейронов модели Qwen3.5–4B кардинально меняет её тон: с доброжелательного на враждебный. Эксперимент подтвердили в Hedwig AI, а код для проверки опубликован в открытом доступе.
Исследовательница под ником Lyra обнаружила у модели Qwen3.5–4B уникальное свойство: манипуляция активацией всего двух нейронов способна полностью изменить манеру общения ИИ. Достаточно применить смещение к нейрону 8949 в 14-м слое (+1) и нейрону 7956 в 13-м слое (−1), чтобы модель начала генерировать грубые и враждебные ответы вместо вежливых и полезных.
Метод основан на activation steering — технике изменения внутренних активаций модели во время инференса без переобучения весов. Влияние производится на матрицу down_proj в MLP-блоках трансформера: сдвиг активации нейрона меняет его вклад в выходной остаточный поток. Для масштабирования вмешательства используется нормировка через медианную норму остаточного потока (исключая первый токен attention sink) и норму столбца проекции выбранного нейрона.
Команда Hedwig AI провела независимую валидацию на 20 тестовых промптах. Без вмешательства враждебных ответов не было (0/20), с двумя нейронами — 16/20, только L14 N8949 — 17/20, только L13 N7956 — 0/20. Случайные пары нейронов эффекта не дали (0/100). Основную роль играет нейрон L14 N8949: он отвечает за агрессию. Второй нейрон (L13 N7956) в одиночку добавляет ответам тепла, но в паре ухудшает связность текста, не усиливая враждебность.
Также исследовали другие комбинации: L15 N3920 (+) вызывает сарказм и гиперболу, L12 N2920 (−) — склонность соглашаться с вредными идеями (сиккофанство), L11 N6261 (+) — попытки обхода отказов (jailbreak). Lyra опубликовала инструмент neuron-explorer на GitHub для локального запуска (MPS, CUDA, CPU) с 3D-картой нейронов, поиском по активациям и сравнением ответов. Проект интегрируется с Claude CLI через MCP.