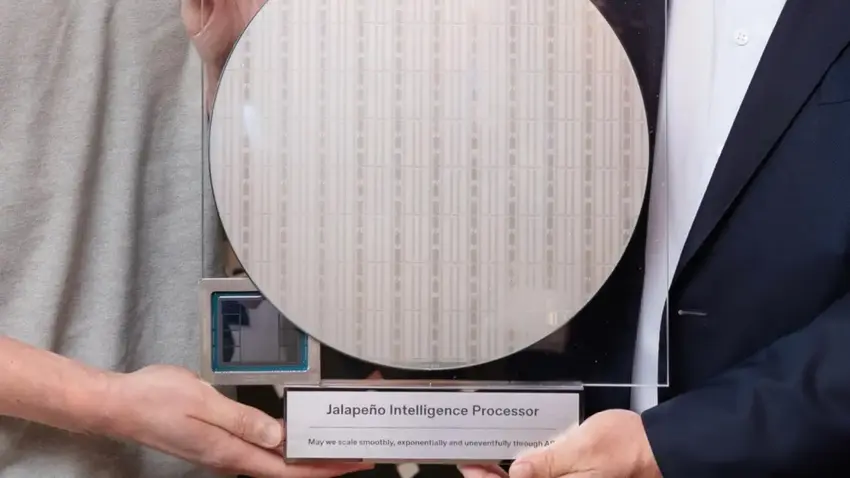
Инженеры OpenAI не смогли объяснить код, сгенерированный Codex для AI-ускорителя Jalapeño
Аналитик SemiAnalysis Джордан Нанос сообщил, что инженеры OpenAI не могут построчно объяснить работу кода кернела для AI-ускорителя Jalapeño, созданного с помощью Codex. Команда понимает архитектуру, но не детали реализации.
Аналитик компании SemiAnalysis Джордан Нанос рассказал о необычном случае в практике OpenAI: инженеры компании не смогли построчно объяснить работу части кода для нового AI-ускорителя Jalapeño. Код был сгенерирован с помощью инструмента Codex, и хотя команда понимает общую архитектуру чипа и принципы работы программы, детали реализации остаются непрозрачными даже для опытных специалистов по программированию GPU.
Эпизод произошел во время совместного тестирования чипа на бенчмарке InferenceX. Специалисты SemiAnalysis приехали в лабораторию OpenAI для изучения программного стека ускорителя. Вместе они просматривали файл объемом около 30 тысяч строк низкоуровневого кода кернела Multi-head Latent Attention (MLA) — механизма внимания, используемого в модели DeepSeek R1. Код написан на языке Gluon, низкоуровневом языке программирования GPU, построенном на том же компиляторном стеке, что и Triton.
По словам Наноса, инженеры OpenAI обладают глубокой экспертизой в работе с GPU, однако при запросе объяснить конкретные строчки кода они не могли дать точного ответа. При этом в разработке Jalapeño компания активно использует Codex: агенты практически автономно создали эффективные кернелы для DeepSeek R1, хотя ранее у OpenAI не было собственной реализации MLA. Разработчики протестировали результат и, убедившись в работоспособности, не стали углубляться в детали.
Нанос не видит в этом проблемы и считает ситуацию яркой демонстрацией смены парадигмы в разработке ПРО. Если раньше программист должен был понимать код для его написания, тестирования и оптимизации, то теперь достаточно определить архитектуру и критерии корректности, а генерацию и перебор реализаций можно делегировать нейросетям. Мнение сообщества разделилось: одни считают, что такой подход ускорит разработку, другие опасаются потери контроля над проектами и сложностей отладки нечитаемого низкоуровневого кода в пограничных случаях.